 Naar de inhoud
gesprek
Wie praatte langer: jouw aandeel in de tijd, onderbrekingen en beurtlengte
Drie cijfers over een gesprek die niemand uit zichzelf onthoudt: hoe lang jij sprak, wie wie afkapte en hoe lang je beurten waren. En waarom geen van drieën een juiste waarde heeft.
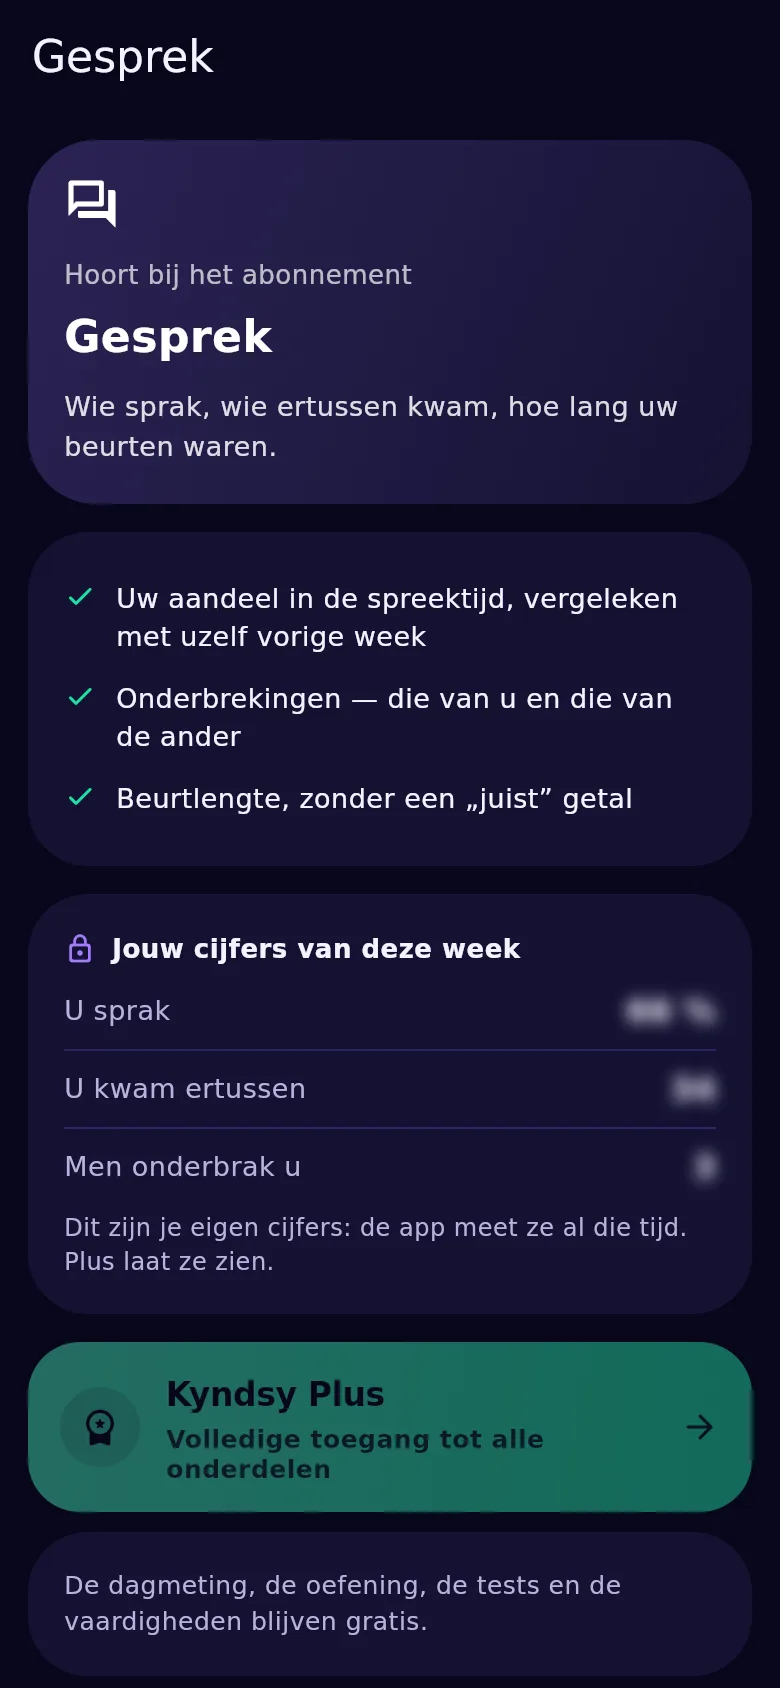
Van een gesprek blijft een gevoel over, geen cijfer. «Ik denk dat ik luisterde», «hij kapt me altijd af» — en niets om het aan te toetsen: niemand neemt iets op, en het geheugen buigt het hele gesprek naar hoe het eindigde. Kyndsy telt drie dingen: hoe lang jij sprak, hoe vaak spraak elkaar overlapte in elke richting en hoe lang je beurten waren.
Jouw aandeel in de spreektijd — en waarom vijftig-vijftig geen doel is
De app deelt de tijd in «jij» en «niet jij»: je eigen stem wordt herkend, de rest gaat alleen in een tijdteller en wordt verder niet ontleed. Er komt een aandeel uit: hoeveel minuten van het uur jij praatte.
Een juiste waarde heeft het niet, en dat cijfer staat nergens op het scherm. Tachtig procent in een vergadering die jij leidt is normaal; diezelfde tachtig tegenover iemand die zijn zorgen kwam vertellen is iets heel anders. Het cijfer beantwoordt «hoeveel», niet «was dat goed».
Onderbrekingen tellen in beide richtingen
Onderbreken is overlappende spraak: twee mensen praten tegelijk, langer dan een kort «mm-hm». Wat jij deed en wat jou werd aangedaan zijn twee aparte cijfers naast elkaar.
Zo verdwijnt de grootste zelfmisleiding van het gesprek: «ik word steeds onderbroken» wordt op hetzelfde scherm getoetst als «ik onderbreek nooit iemand». Meestal is geen van beide nul, en dat is het nuttigste wat je in een week leert.
Beurtlengte: monoloog en afgekapte antwoorden zijn dezelfde fout
De gemiddelde lengte van je beurt zegt meer over een gesprek dan het aandeel. Drie seconden achtereen zijn afgekapte antwoorden waar de ander niets aan heeft; vijfenveertig is een monoloog waar hij niet in wordt toegelaten.
De cijfers staan met opzet naast het aandeel. Twintig procent van de tijd in korte beurten en twintig procent in één blok zijn bij hetzelfde aandeel twee heel verschillende gesprekken.
Wat de app in een gesprek NIET doet
Ze ontleedt niet waarover jullie spraken en beslist niet wie gelijk had: de inhoud gaat haar niet aan. De spraak van de ander wordt helemaal niet herkend — de stemcontrole staat vóór de herkenning, en zijn woorden gaan nergens heen.
Er blijft geen geluid en geen transcript over: in de database staan minuten, een aantal overlappingen en de lengte van beurten. Uit die cijfers valt geen gesprek te reconstrueren — dat is geen beperking maar de voorwaarde waaronder de app überhaupt luistert.
Waarom cijfers zonder juiste waarde
Om dezelfde reden als een weegschaal: die zegt niet wie je moet zijn, hij laat beweging zien. Deze week tegen vorige week is de enige vergelijking die hier iets betekent.
En omdat een gesprek de enige plek is waar jouw spraak die van een ander tegenkomt. Al het andere telt de app over jou; dit gaat over hoe je de tijd deelt met de mens tegenover je.
Honderd manieren om naar jezelf te kijken
Erover lezen is één ding. Tien van de tests staan hier open — zonder installatie, zonder account, er wordt niets bewaard.